Umělá inteligence Facebooku dokáže analyzovat memy, ale dokáže jim porozumět? Technologie Rosetta od Facebooku analyzuje miliardy obrázků, které obsahují text, ale memy jsou pro umělou inteligenci příliš složité. Každý den jsou na sociální sítě nahrány miliardy textů, fotografií a videí. Jedná se o množství informací, které lidští moderátoři a jejich ověřovatelé faktů nemohou komplexně prosít, kontrolovat a kontrolovat. Společnosti jako Facebook a YouTube již dlouho spoléhají na umělou inteligenci, aby zabránily spamu, násilí, kritickému obsahu a pornografii mimo jejich platformy!
Něco jako systémově kritický mem bez textu může být pro jeho superpočítače a jejich algoritmy obtížné analyzovat a zpracovat, protože tento úkol vyžaduje výpočet několika různých vizuálních prvků současně. Automatizované systémy, tzv. bot systémy, musí rozpoznat a „přečíst“ slova nad fotografií a analyzovat a přiřadit samotný obrázek. Memy lze také popsat jako komplikované kulturní artefakty, které je těžké pochopit mimo kontext. Navzdory problémům, které představují, všechny hlavní sociální platformy již používají AI k ovládání memů, včetně Facebooku, který používá nástroj zvaný Rosetta k analýze fotografií a videí obsahujících text a popisky.
Podle Facebooku se Rosetta již používá k automatické detekci obsahu, který porušuje pokyny k projevům nenávisti. S pomocí Rosetty se Facebook snaží kontrolovat uživatelský obsah včetně fotografií a videí, nikoli pouze textové příspěvky. Rosetta podporuje proces, při kterém se automaticky kontroluje, zda byly obrázky a videa obsahující text dříve označeny jako „kritické“. Rosetta kombinuje technologii OCR (optické rozpoznávání znaků) s dalšími technikami strojového učení pro prohlížení, zpracování, klasifikaci a přiřazování textu na fotografiích a videích a na nich a poté jej ukládá. Za prvé, OCR se používá k určení, kde je text v memu nebo videu. To jim umožňuje rychle transformovat data a používat jejich „selektory“ k vyhodnocení obsahu.
Jakmile Rosetta ví, kde jsou slova, Facebook použije neuronovou síť, která dokáže porozumět textu, jeho přepisu a významu. Tento text pak může být předán dalším systémům, jako je systém, který kontroluje, zda je mem virovou zprávou, která již byla odhalena podle jejich pokynů. Vývojáři a výzkumníci společnosti Rosetta tvrdí, že nástroj nyní dokáže v reálném čase extrahovat text z jakéhokoli obrázku veřejně nahraného na Facebook a rozpoznat texty a také „číst“ jejich jazykové identifikátory, včetně angličtiny, španělštiny, němčiny a arabštiny.
Rosetta může také analyzovat obrázky, které obsahují text v mnoha různých formách, jako jsou fotografie protestních nápisů, jídelní lístky restaurací, výlohy obchodů a další. Viswanath Sivakumar, softwarový inženýr na Facebooku, který pracuje na Rosettě, v e-mailu uvedl, že tento nástroj funguje dobře jak pro identifikaci textu v krajině, jako je značka ulice, tak pro memy – ale to druhé je náročnější. „V kontextu proaktivního odhalování nenávistných projevů a dalšího obsahu, který porušuje zásady, představují obrázky ve stylu memů složitější výzvu AI,“ napsal.
Na rozdíl od lidí potřebuje AI také obvykle vidět desítky tisíc příkladů, než se naučí dokončit komplikovaný úkol, říká Sivakumar. Memy však nejsou neomezeně ovladatelné, dokonce ani pro Facebook, a shromažďování a ukládání dostatečného množství příkladů v různých jazycích a emocích může být také obtížné. Hledání vysoce kvalitních zpráv je pokračující výzvou pro výzkum umělé inteligence v širším měřítku. Data je často potřeba pečlivě ručně označit a archivovat. Mnoho databází je také chráněno autorským právem.
Aby bylo možné Rosetta nakrmit potřebnými daty a trénovat její užitečnost, je text spolu s jeho titulky a místy, ze kterých byly publikovány, spojen do výpočetního procesu. Jednoduše řečeno, vytvořili jste program na vytvoření přesně těch příkladů, jejichž obsah se zdá sporný. To znamená, že celý proces je do určité míry automatizován: jeden program memy automaticky vyplivne a jiný se je snaží analyzovat. AI bude čelit velmi velkým výzvám. Rosetta se například potýká s jazyky, jako je arabština, která se čte zprava doleva, na rozdíl od jiných jazyků, jako je angličtina nebo němčina. Rosetta „čte“ arabsky pozpátku, pak Facebook po zpracování obrátí znaky. Tento trik funguje překvapivě dobře a umožňuje jednotný model, který funguje pro jazyky psané zleva doprava i zprava doleva.
Automatizované systémy mohou být extrémně užitečné pro moderování obsahu a ověřování faktů, ale nejsou vždy snadné. Například WeChat používá k filtrování obrázků dva různé algoritmy. První, program založený na OCR, filtruje fotografie, které obsahují text o zakázaných tématech, zatímco ostatní cenzurují obrázky podobné těm na černé listině pravděpodobně vytvořené čínskou vládou. Prostřednictvím filtrů WeChat můžete snadno odstranit vlastnosti obrázku, stejně jako zbarvení nebo změněnou orientaci. Rossetta od Facebooku je složitá, ale pravděpodobně ne dokonalá. Systém lze obejít špatně čitelným textem nebo zdeformovaným písmem. Všechny algoritmy pro rozpoznávání obrázků jsou také stále potenciálně zranitelné vůči konfliktním příkladům, mírně pozměněným obrázkům, které lidem vypadají stejně, ale způsobí zmatení umělé inteligence.
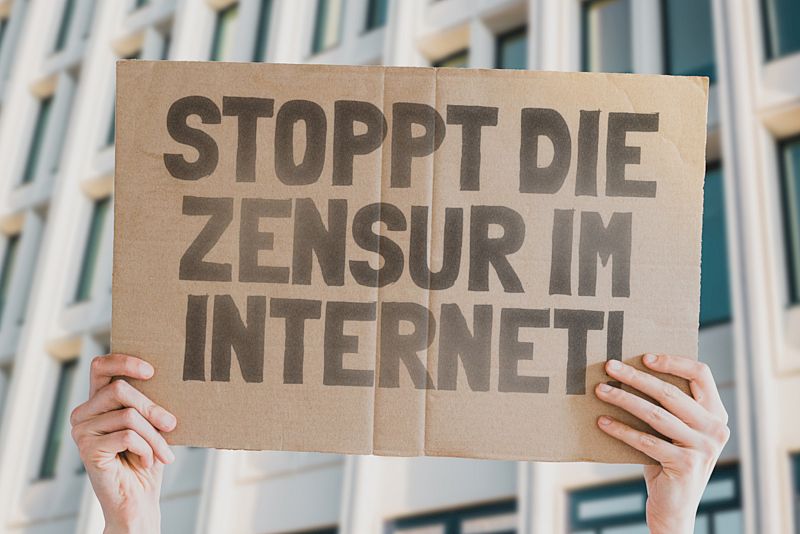
Facebook a další platformy, jako je Twitter, YouTube a Reddit, jsou pod obrovským tlakem, aby hlídaly určité typy obsahu v několika zemích. V roce 2018 Evropská unie navrhla nové zákony, které by společnostem na sociálních sítích vyžadovaly, aby odstranily teroristické příspěvky do hodiny od oznámení, jinak jim hrozí pokuta. Rosetta a další podobně automatizované nástroje již pomáhají Facebooku a dalším platformám dodržovat podobné zákony v zemích, jako je Německo. A ve své práci se zlepšují: Před dvěma lety generální ředitel Mark Zuckerberg řekl, že systémy umělé inteligence Facebooku proaktivně zachycují pouze asi polovinu obsahu, který společnost odstranila. Zbytek si lidé musí nejprve označit. Podle Facebooku jeho nástroje AI detekují téměř 100 procent spamu, který odsuzují, stejně jako 99,5 procenta teroristického obsahu a 86 procent grafického násilí. Jiné platformy, jako je YouTube, dosáhly podobného úspěchu s automatizovanými systémy rozpoznávání obsahu.
To však neznamená, že systémy umělé inteligence jako Rosetta jsou dokonalým řešením, zejména pokud jde o jemnější formy vyjádření. Na rozdíl od jídelního lístku v restauraci může být obtížné analyzovat význam memu bez znalosti kontextu, ve kterém byl zveřejněn. Proto existují celé weby, které je vysvětlují. Memy se často objevují uvnitř vtipů nebo jsou velmi specifické pro určitou online subkulturu a její morální a etické pozadí. A umělá inteligence stále není schopna porozumět memu nebo videu tak, jak by to člověk pochopil. Facebook se zatím bude muset stále spoléhat na lidské moderátory a jejich ověřovatele faktů, aby se rozhodli, zda meme odstranit.
Překlad článku z časopisu Wired ze 14.09.2018. září XNUMX
(Via Vale Rion)
Více pro vás:
 „Dravens Tales from the Crypt“ okouzluje již více než 15 let nevkusnou směsí humoru, seriózní žurnalistiky – pro aktuální události a nevyváženého zpravodajství v tiskové politice – a zombie, zdobený spoustou umění, zábavy a punk rocku. Draven ze svého koníčka udělal oblíbenou značku, kterou nelze zařadit.
Můj blog nikdy nebyl navržen tak, aby šířil zprávy, natož aby byl politický, ale s aktuálními událostmi si prostě nemohu pomoci a nezachytím zde informace, které jsou jinak cenzurovány na všech ostatních kanálech. Jsem si vědom toho, že designová stránka nemusí mnohým v tomto ohledu připadat „seriózní“, ale nebudu to měnit, abych se zalíbil „mainstreamu“. Každý, kdo je otevřený informacím, které nejsou v souladu se státem, vidí obsah, nikoli obal. Za poslední 2 roky jsem se snažil poskytnout lidem informace, ale rychle jsem si všiml, že nezáleží na tom, jak jsou „zabalené“, ale jaký k tomu má postoj druhého. Nechci nikomu natírat med na ústa, abych v žádném případě splnil očekávání, takže si nechám tento návrh, protože doufejme, že v určitém okamžiku budu moci přestat s těmito politickými prohlášeními, protože není mým cílem pokračovat takhle navždy  Nechám na každém, jak se k tomu postaví. Nicméně, můžete jednoduše kopírovat a distribuovat obsah, můj blog byl vždy pod Licence WTFPL.
Je pro mě těžké popsat, co tady vlastně dělám, z DravensTales se v průběhu let stal blog o kultuře, hudební blog, šokující blog, tech blog, hororový blog, zábavný blog, blog o nalezených položkách na webu, o internetu bizarní, trash blog, art blog, ohřívač vody, blog zeitgeistů Volal blog šrotu a blog sáčku. Všechno, co je správné ... - a přesto ne. Hlavním zaměřením blogu je současné umění v nejširším slova smyslu.
Abychom zajistili nepřetržitý provoz těchto stránek, můžete přispět prostřednictvím kreditní karty, PayPal, Google Pay, Apple Pay nebo inkasa/bankovního účtu . Všem čtenářům a podporovatelům tohoto blogu mnohokrát děkujeme!